Perda Financeira por Fraude: Por Que o Modelo Que Funcionava Já Não Basta
- 21 Outubro 2026
- Fraude
O modelo que funcionava parou de proteger como antes
Em algum momento, todo modelo de antifraude em produção deixa de apresentar o resultado como apresentava no primeiro mês. Isso raramente é percebido como falha, é percebido como parte natural da operação: a assertividade cai aos poucos, o time de risco ajusta o ponto de corte, a rotina segue. É justamente essa normalização que esconde um problema estrutural por trás de um detalhe de manutenção.
Isso não é falha de projeto. Todo modelo preditivo nasce do passado, e em fraude o presente muda rápido: o ciclo de vida de um ataque, que antes durava meses, hoje se reinventa em semanas. Um modelo estático nasce assertivo e degrada a partir do primeiro dia em produção.
Essa degradação não aparece primeiro na reunião do comitê de risco. Aparece primeiro na métrica de separação do modelo, e só depois no caixa: mais fraude não capturada, mais fricção para compensar a queda de assertividade, mais cliente legítimo barrado por engano. É assim que a degradação técnica de um modelo vira perda financeira por fraude, de forma silenciosa e cumulativa.
Três números técnicos resumem o problema em termos de resultado:
-
KS (Kolmogorov-Smirnov): separa transação legítima de fraudulenta. Quando cai, a capacidade do modelo de distinguir uma da outra cai junto.
-
FNR (False Negative Rate): fração de fraude que passou, classificada como legítima. É perda financeira direta, sem desconto.
-
Detection Rate: percentual de fraude capturada em um ponto de corte de fricção. Mais detecção no mesmo corte significa mais fraude pega sem incomodar o cliente bom.
É esse conjunto, janela de exposição, fricção crescente e perda financeira, que separa um modelo que funcionava de um modelo que continua funcionando. O resto deste artigo trata exatamente disso: por que essa degradação é estrutural, não acidental, o que mostra uma medição real e rigorosa desse fenômeno, e qual mudança de paradigma resolve o problema pela raiz, em vez de tratá-lo como manutenção periódica.
Concept drift: o adversário que não para de mudar de estratégia
Na literatura de aprendizado de máquina, esse fenômeno tem nome: concept drift, a mudança, ao longo do tempo, da relação estatística entre os dados de entrada e o resultado que um modelo tenta prever. Qualquer modelo preditivo aplicado a um ambiente que muda sofre com isso, em algum grau, mais cedo ou mais tarde.
Fraude é um dos casos mais extremos desse problema, por um motivo específico: o ambiente não muda sozinho, ele muda em resposta ao próprio modelo. Em boa parte dos problemas de predição, como estimar demanda ou risco de inadimplência, o comportamento subjacente evolui devagar e sem intenção. Em fraude, do outro lado da predição existe um adversário ativo, que testa o modelo, observa o que funciona e o que é bloqueado, e ajusta a própria estratégia deliberadamente para encontrar a próxima brecha. Não é um ambiente que muda, é um ambiente que reage.
Essa dinâmica fica mais evidente quanto maior o volume da operação. Um banco de grande porte processa algo como 750 milhões de transações de Pix, TED e cartão por mês, contra cerca de 500 mil novas contas abertas no mesmo período. É nesse volume transacional que um fraudador bem-sucedido encontra espaço para testar variações de estratégia repetidamente, e é no mesmo volume que cada ponto percentual de detecção, ganho ou perdido, se traduz em dezenas de milhões de reais.
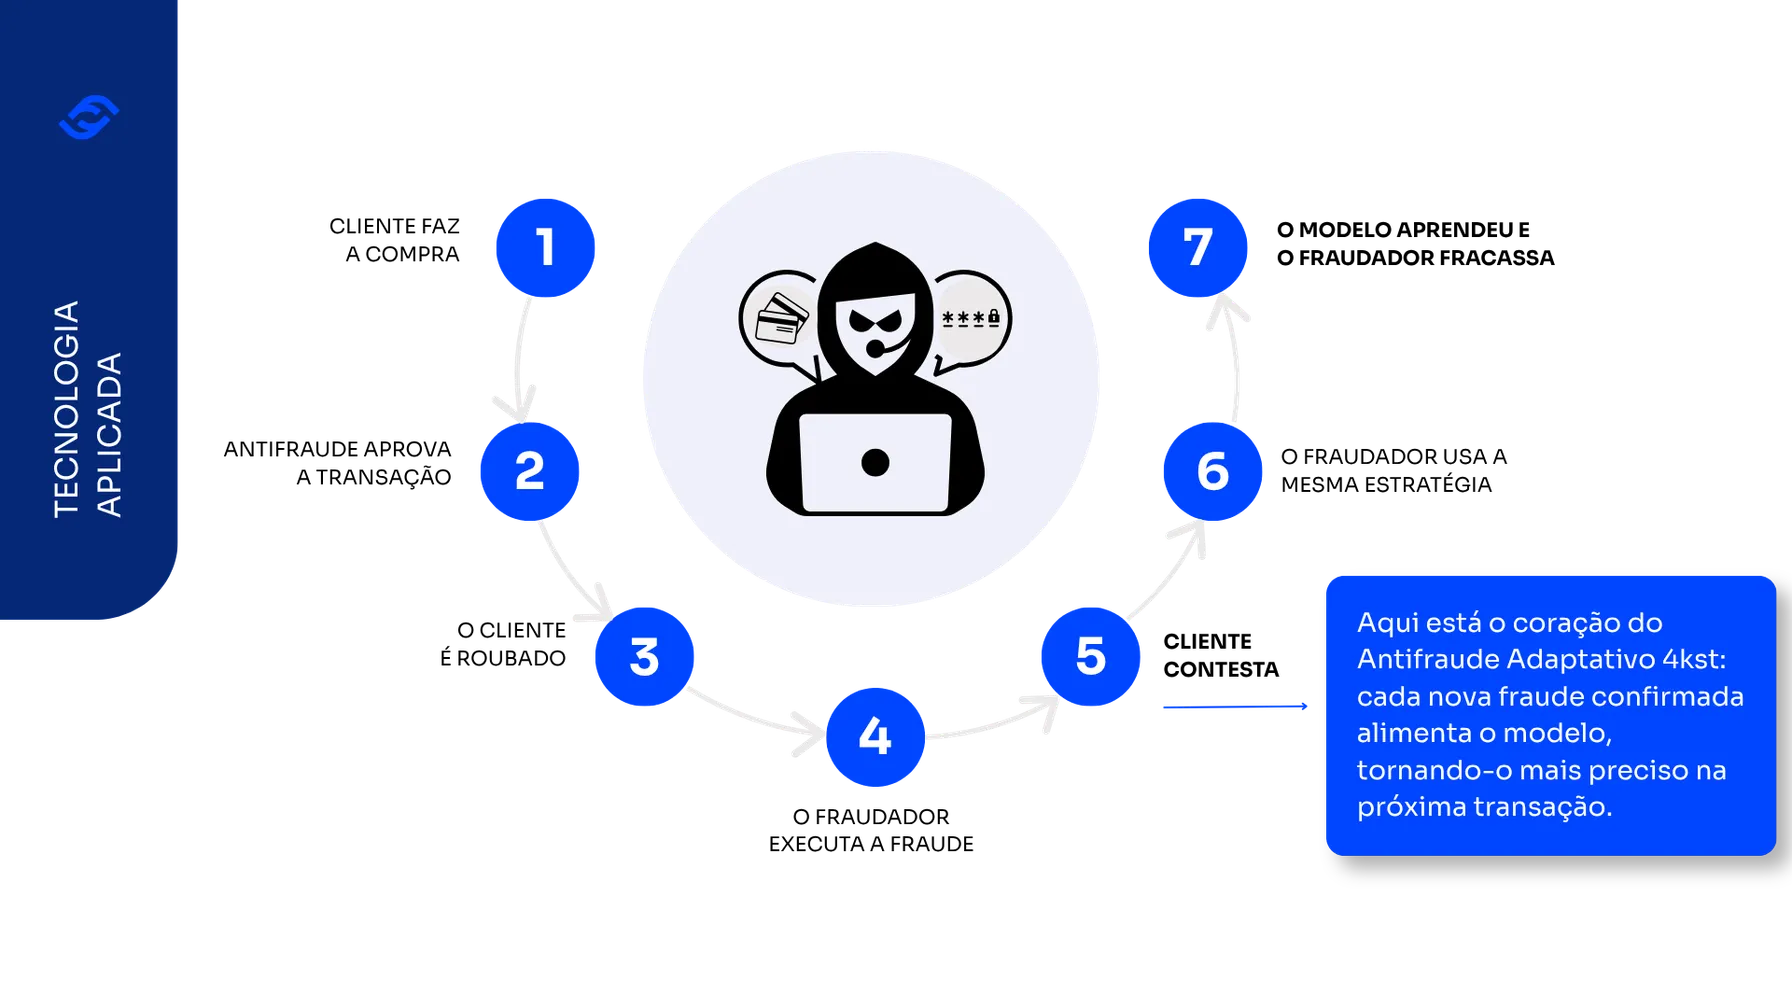
A jornada da fraude
O ciclo é simples de explicar e já mostra, em cinco passos, por que atualização contínua vence modelo estático.
O que isso custa, em números reais
Os números abaixo vêm de um estudo real: dentro da operação de um grande banco de varejo brasileiro, um modelo antifraude estático e o modelo Antifraude Adaptativo 4kst foram comparados lado a lado, na mesma arquitetura e nos mesmos dados. A única variável que mudou foi a metodologia, treino único contra atualização contínua, o que torna a comparação praticamente um experimento controlado.
Em PIX PJ, o segmento mais crítico do estudo, o modelo adaptativo 4kst capturou R$104 milhões a mais em fraude, uma recuperação 47,7% maior, o equivalente a R$467 milhões em perdas evitadas. Em TED PJ, R$14,62 milhões a mais em captura, 66% de recuperação a mais, R$65 milhões em perdas evitadas.
Por trás desses números, a métrica técnica: em PIX PJ, o modelo estático degradou 21% no KS em 15 meses, e a FNR, a fração de fraude que passa batida, foi de 26% para 14% com o modelo adaptativo, uma redução relativa de 46%. Em TED PJ, durante um ataque real, a capacidade de detecção do modelo estático despencou de 74% para 44%, enquanto o modelo atualizado continuamente chegou a um KS de 96,5% e manteve 79% de detecção no mesmo corte de fricção.
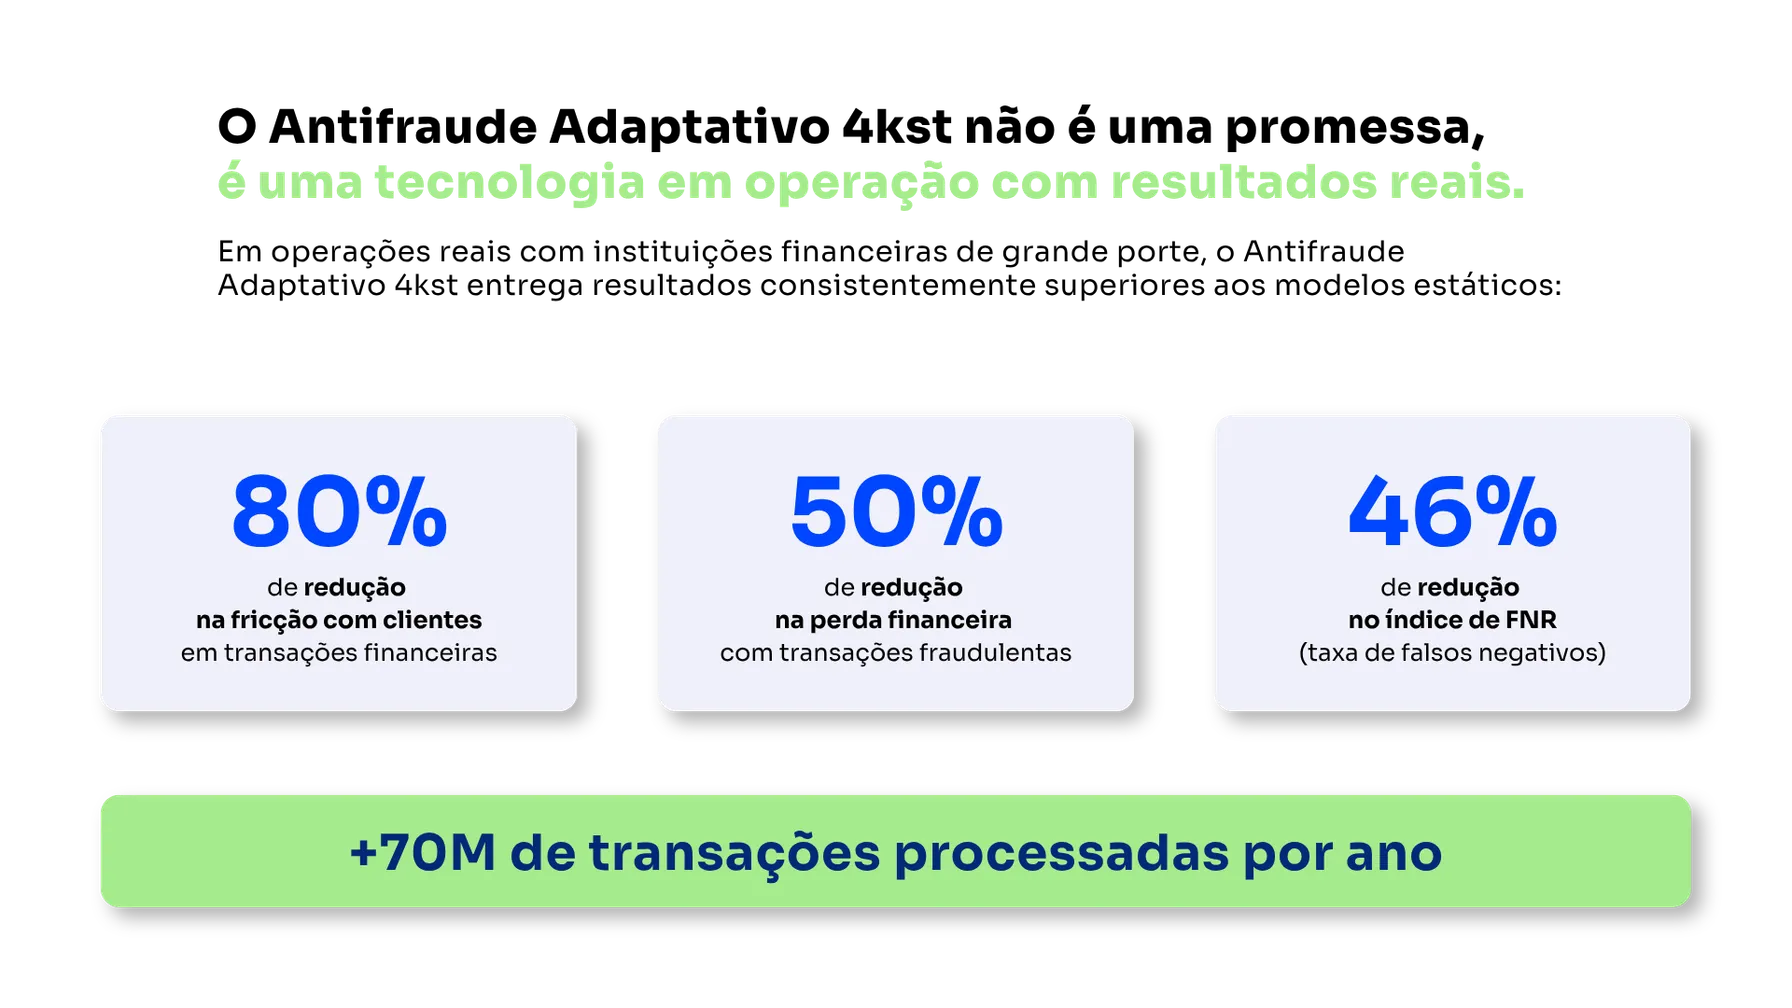
No agregado dessas operações reais, isso se traduz em até 80% de redução na fricção com clientes legítimos e 50% de redução na perda financeira.
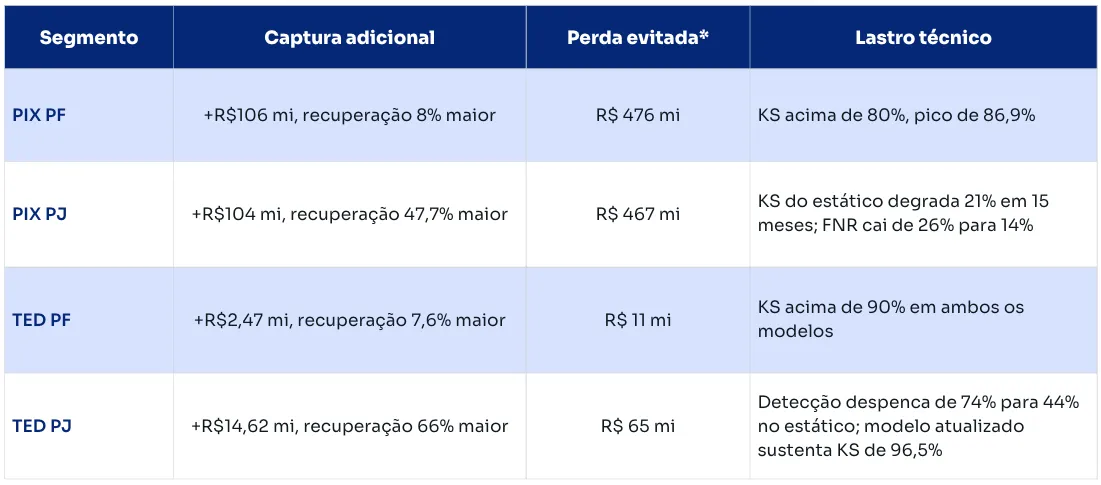
*Multiplicador de custo operacional de R$4,49 × R$1,00 fraudado (fonte: Valor Econômico)
O mesmo padrão aparece em outras frentes do portfólio: autorização de cartão de crédito com 40% a mais de fraudes detectadas e 34% a menos de negativações indevidas, e originação de cartão com 64% a mais em vendas aprovadas e 21% a menos de derivação para mesa.
Esses números vêm de uma única operação e servem como referência de magnitude, não como garantia numérica para qualquer operação nova. Cada modelo é validado no backtest com os dados da própria operação do cliente antes de qualquer decisão de produção.
O paradigma que resolve isso: Data Stream Learning
A resposta técnica para esse problema existe há mais de uma década na pesquisa de machine learning, sob o nome de aprendizado incremental, ou aprendizado em fluxo (stream learning): em vez de treinar um modelo uma única vez sobre um lote fechado de dados e substituí-lo periodicamente, o modelo é atualizado de forma contínua, incorporando cada novo evento assim que ele é confirmado, sem descartar o que já aprendeu.
Aplicada à prevenção de fraude, essa abordagem resolve exatamente a janela que o fraudador explora. Em vez de esperar um novo ciclo de retreino, o modelo incorpora os atributos de cada fraude confirmada no momento em que ela é confirmada, fechando a porta antes que o fraudador repita a estratégia. O modelo não é retreinado nem recalibrado nesse paradigma, ele é atualizado continuamente, uma distinção que descreve uma arquitetura diferente, não uma versão mais rápida da mesma arquitetura. Vale uma segunda precisão: tempo real aqui descreve a atualização do modelo, não a consulta, que já é real time por padrão em qualquer motor de antifraude do mercado.
É essa tecnologia, batizada de Data Stream Learning, que gerou os números da seção anterior. Quem desenvolveu essa tecnologia no Brasil, como produto de Adaptive AI aplicado à prevenção de fraude, foi a 4kst. O modelo mantido com atualização contínua discutido até aqui é o Antifraude Adaptativo 4kst.
Isso não é automação sem controle. Cada atualização passa primeiro por um modelo em ambiente de homologação, rodando em modo shadow, validado antes de qualquer promoção para produção. O time interno do cliente mantém governança total sobre o que entra em produção.
O que isso representa no TCO
Menos perda financeira e menos fricção não aparecem sozinhas na conta. Menos esforço manual de recalibragem também compõe o TCO, o custo total de propriedade da operação de risco e fraude: cada retreino periódico consome tempo do time de dados que poderia estar em projetos de maior valor. A soma dessas três reduções, perda financeira, fricção operacional e esforço manual, é que explica a queda direta no custo total da operação, não apenas a métrica isolada de detecção.
Perguntas frequentes
O que é concept drift? É a mudança, ao longo do tempo, da relação estatística entre os dados que um modelo usa para prever e o resultado que ele tenta prever. Um modelo treinado sobre um padrão de comportamento perde precisão quando esse padrão muda, mesmo que o modelo em si não tenha mudado.
Como saber se um modelo de fraude está degradando? O primeiro sinal aparece na métrica de separação do modelo (KS) e na taxa de detecção em um ponto de corte fixo, antes de aparecer na perda financeira. Uma queda consistente nessas métricas entre ciclos de retreino, sem mudança na arquitetura do modelo, é o sinal mais confiável.
Esse problema é exclusivo de fraude? Não, mas fraude é um dos casos mais severos, porque o ambiente reage ativamente ao modelo. Outros problemas de predição, como churn ou previsão de demanda, também sofrem concept drift, mas em ritmo mais lento, porque não têm um adversário do outro lado ajustando estratégia de propósito.
Atualização contínua é o mesmo que retreinar com mais frequência? Não. Retreinar com mais frequência ainda é a mesma arquitetura, treino em lote com substituição periódica, só que com um intervalo menor. Aprendizado contínuo incorpora cada evento confirmado assim que ele acontece, sem esperar um novo ciclo de treino em lote.
O argumento que fecha a conta
A pergunta certa não é se o seu modelo é bom. Um modelo bem construído entra em produção assertivo, boa parte do mercado consegue isso. A pergunta é se ele continua bom seis meses depois, doze meses depois, no meio de um ataque real.
Um modelo estático responde não, estruturalmente: ele degrada entre um ciclo de retreino e outro, e esse intervalo é exatamente a janela que o fraudador explora. O Antifraude Adaptativo 4kst muda essa resposta: não é que o modelo seja melhor no primeiro dia, é que ele continua melhor.
O próximo passo não exige acreditar em projeção. É rodar o backtest com os dados reais da sua própria operação e ver, em reais, quanto a perda financeira por fraude muda entre um modelo que degrada e um que evolui.
Artigos Relacionados
Esteja à frente
da concorrência
Otimize suas decisões estratégicas com as previsões
mais assertivas do mercado.
-
 Conformidade com a LGPD
-
Resolução BCB nº85/2021
-
Certificação ISO/ISE 27001:2022